Statistiche e Analytics per le Scommesse Cricket: Come Usare i Dati
 Available in US
Il giorno in cui i numeri hanno iniziato a parlare
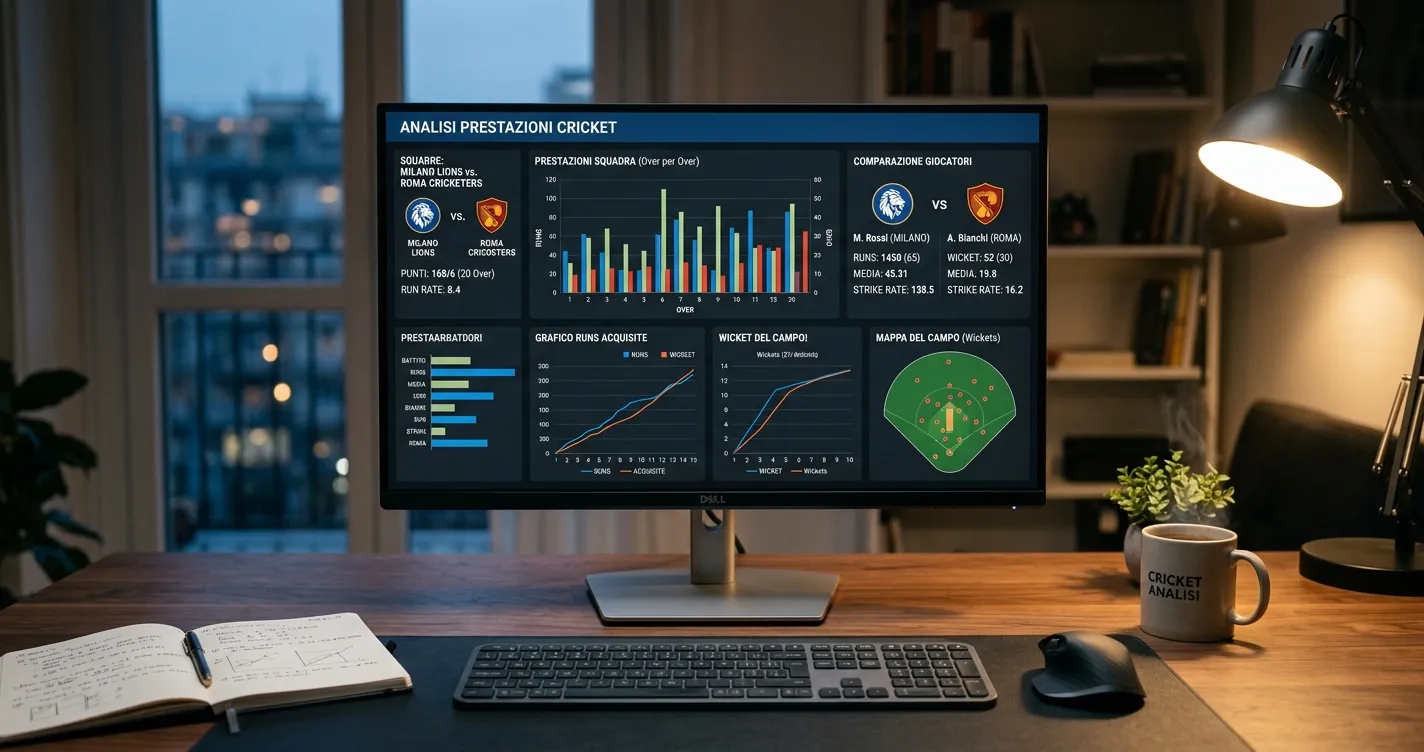
Scommettevo sul cricket da quasi due anni quando un amico mi ha mostrato un foglio di calcolo con le statistiche ball-by-ball di un’intera stagione IPL. Fino a quel momento usavo le medie generali dei giocatori, quelle che trovi su qualsiasi sito. Quel foglio di calcolo mi ha mostrato qualcosa di diverso: come un battitore performa nelle ultime cinque palle di un over rispetto alle prime tre, come un lanciatore cambia strategia dopo aver subito un boundary. Da quel giorno, le medie generali non mi sono più bastate.
Il cricket è lo sport più ricco di dati al mondo dopo il baseball. Ogni palla lanciata produce una serie di informazioni misurabili: velocità, traiettoria, punto d’impatto, direzione del colpo, distanza percorsa. Il mercato globale delle scommesse cricket, che vale 14,45 miliardi di dollari nel 2024, si sta spostando rapidamente verso un approccio data-driven, e chi non si adatta resta indietro.
Metriche che contano e metriche che ingannano
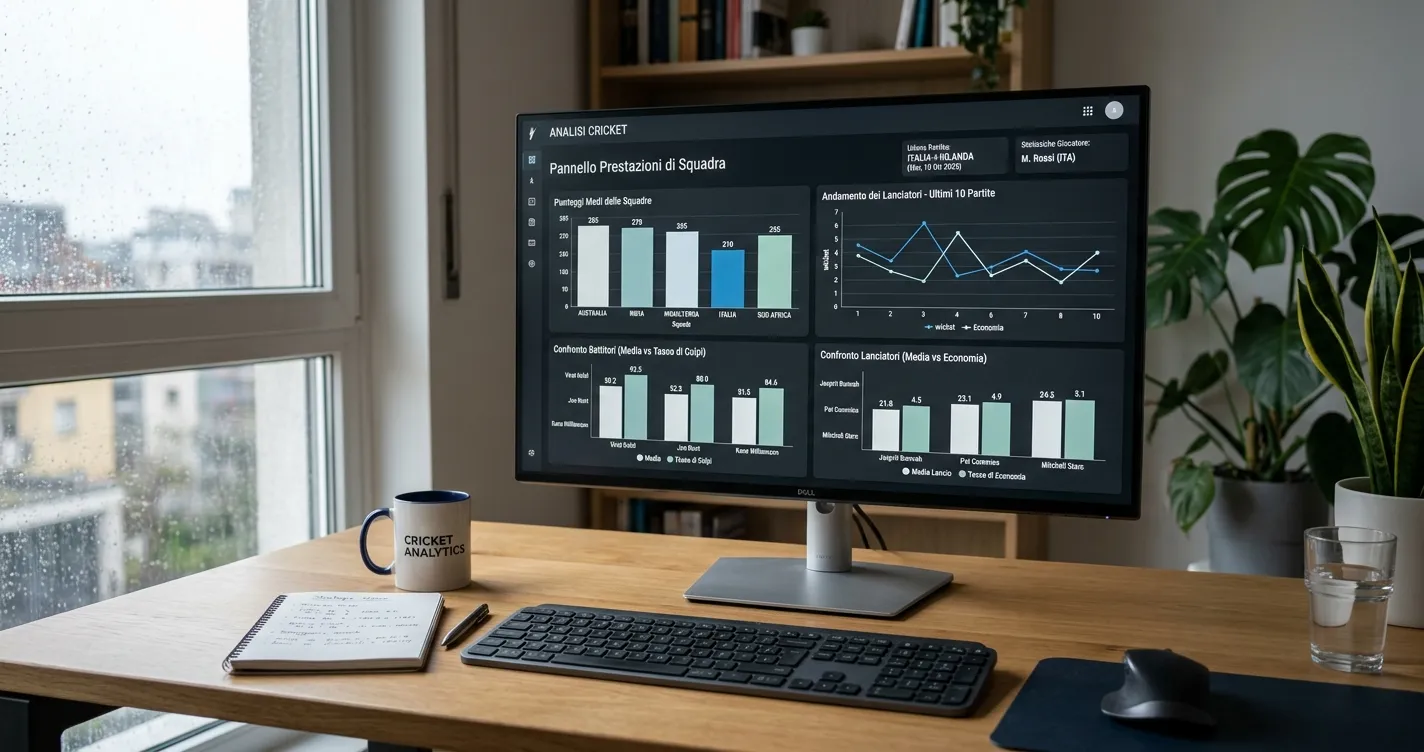
La media battuta è la statistica più citata nel cricket, e anche una delle più ingannevoli per chi scommette. Un battitore con una media di 45 in Test cricket sembra eccellente, e probabilmente lo è. Ma quella media non ti dice come performa contro lo spin su pitch che girano, o se i suoi runs arrivano principalmente contro attacchi deboli. Ho visto giocatori con medie brillanti crollare sistematicamente in condizioni specifiche, e quei crolli sono prevedibili se guardi le metriche giuste.
Lo strike rate contestualizzato è una metrica molto più utile della media grezza. Nel T20, un battitore che segna 30 runs da 30 palle ha un impatto neutro o negativo sulla squadra, anche se la sua media dice 30. Quello che conta è la capacità di accelerare: il rapporto tra runs segnati e palle affrontate nelle diverse fasi dell’innings. Un giocatore che segna a 100 di strike rate nel powerplay ma a 160 nella death overs ha un profilo completamente diverso da uno che fa il percorso inverso.
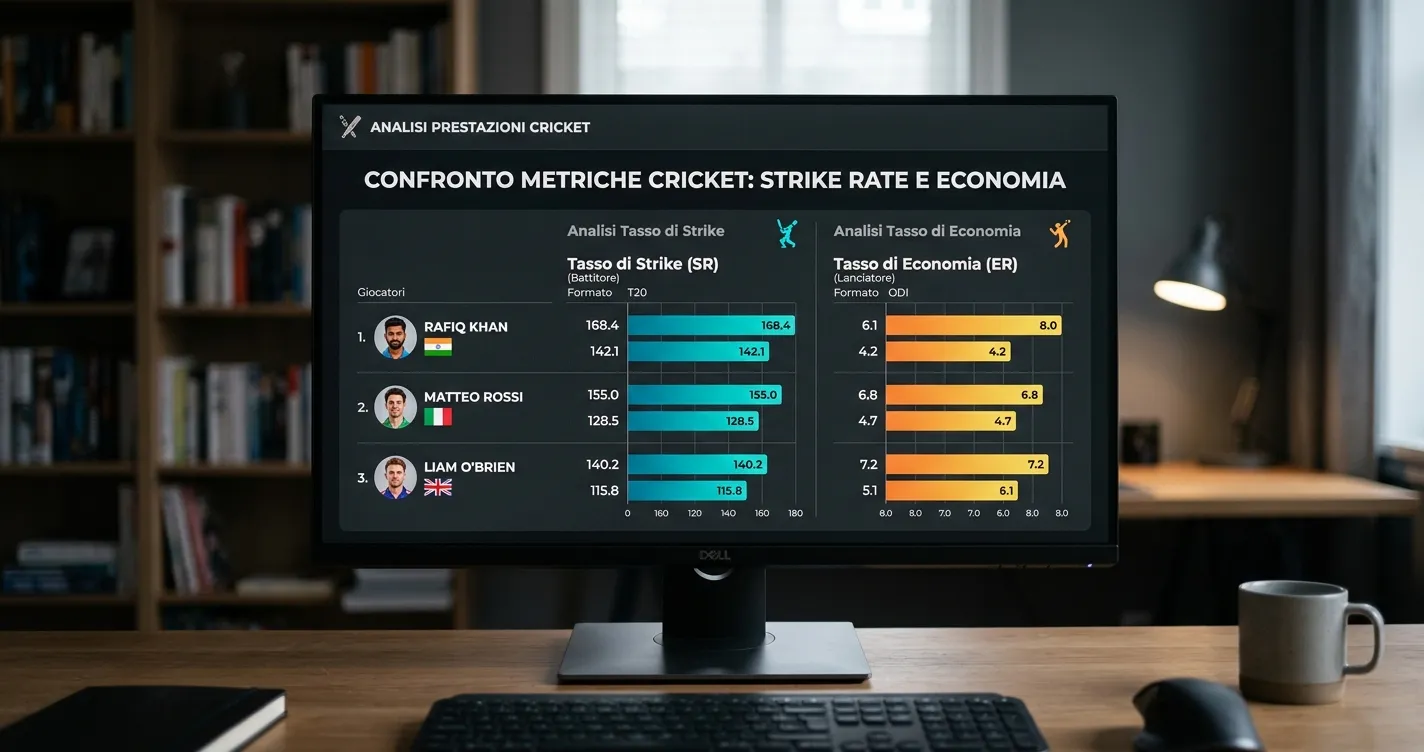
Per i lanciatori, la metrica più sottovalutata è il dot ball percentage, la percentuale di palle su cui il battitore non segna. Nel T20, un lanciatore con un’economy di 7.5 che lancia il 45% di dot balls è molto più affidabile nei momenti critici rispetto a uno con la stessa economy ma solo il 30% di dot balls. Il primo controlla il ritmo, il secondo subisce runs in modo imprevedibile.
Fonti dati e come costruire il proprio database
Quando ho iniziato a raccogliere dati sul cricket, ho fatto un errore che mi è costato settimane: cercare un’unica fonte completa. Non esiste. Il cricket produce dati attraverso diverse piattaforme, e ognuna ha i suoi punti di forza. ESPNcricinfo offre scorecard dettagliate e statistiche storiche. CricViz fornisce analisi ball-by-ball con visualizzazioni sofisticate. I dati Hawk-Eye, quando disponibili, aggiungono informazioni sulla traiettoria tridimensionale della palla.
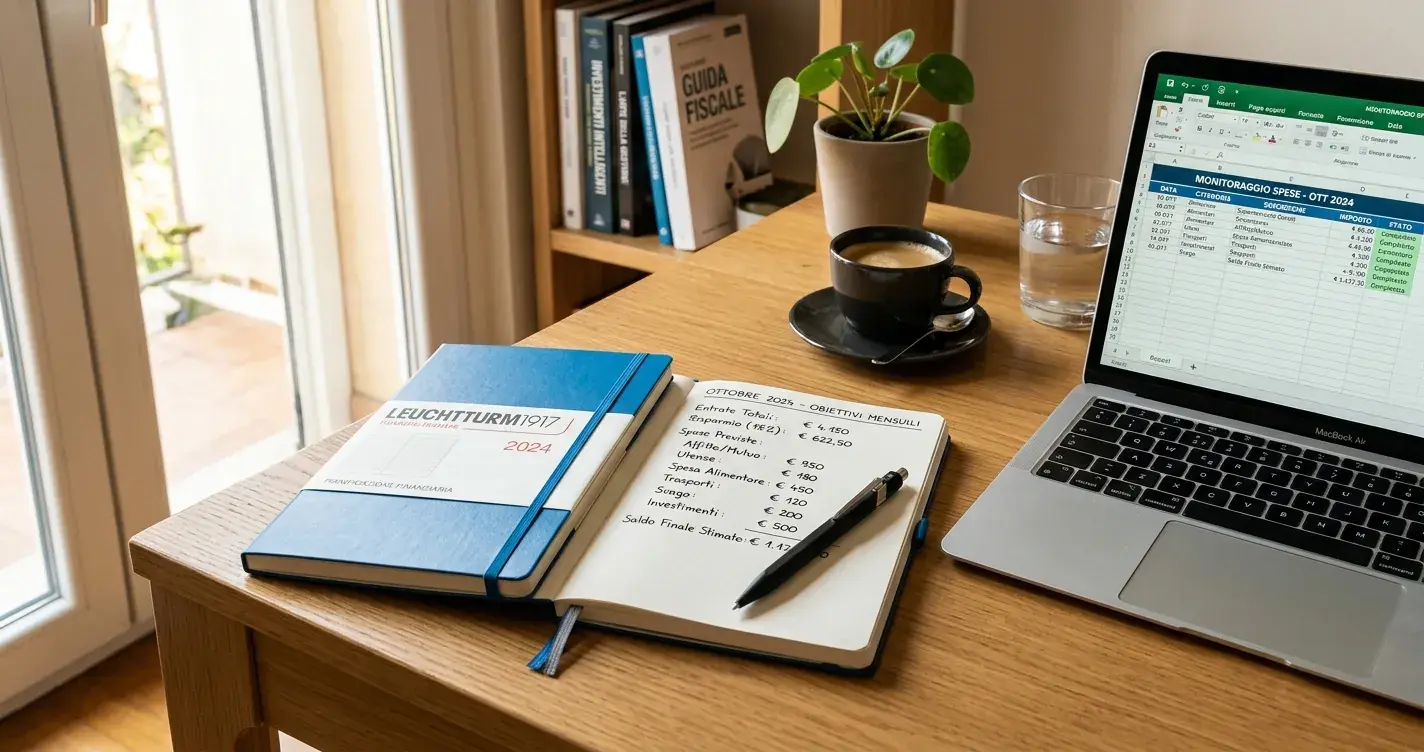
Il mio database attuale combina dati da tre fonti diverse, normalizzati in un formato unico. Ho automatizzato la raccolta dati con script Python che estraggono le informazioni rilevanti dopo ogni partita. Non serve essere programmatori esperti per farlo: un foglio Google con import da feed RSS e qualche formula di pulizia dati è sufficiente per iniziare. L’importante è la costanza nella raccolta, perché i pattern emergono solo con volumi significativi di dati.
Un aspetto che molti trascurano è la qualità dei dati sulle condizioni ambientali. Temperatura, umidità, velocità del vento e punto di rugiada influenzano il comportamento della palla in modi misurabili. Ho integrato dati meteorologici storici nel mio modello e la correlazione con i punteggi è sorprendentemente forte, soprattutto nelle sedi inglesi e neozelandesi dove il meteo è più variabile.
Modelli predittivi dal semplice al complesso
Non servono reti neurali per battere il mercato. Il mio primo modello redditizio era un foglio Excel con ventisei variabili e una regressione lineare multipla. Funzionava perché catturava relazioni che i bookmaker non stavano ancora prezzando, come la correlazione tra il rendimento di un lanciatore nelle prime due partite di un torneo e la sua performance nelle successive.
Le trentacinque-quaranta percento di upset rate nelle partite T20, un dato confermato da anni di analisi, è il punto di partenza per qualsiasi modello. Se le sorprese accadono in più di un terzo delle partite, significa che i favoriti sono sistematicamente sopravvalutati. Il mio modello non cerca di prevedere chi vincerà, ma di identificare partite in cui la probabilità implicita nella quota è significativamente diversa dalla probabilità reale.
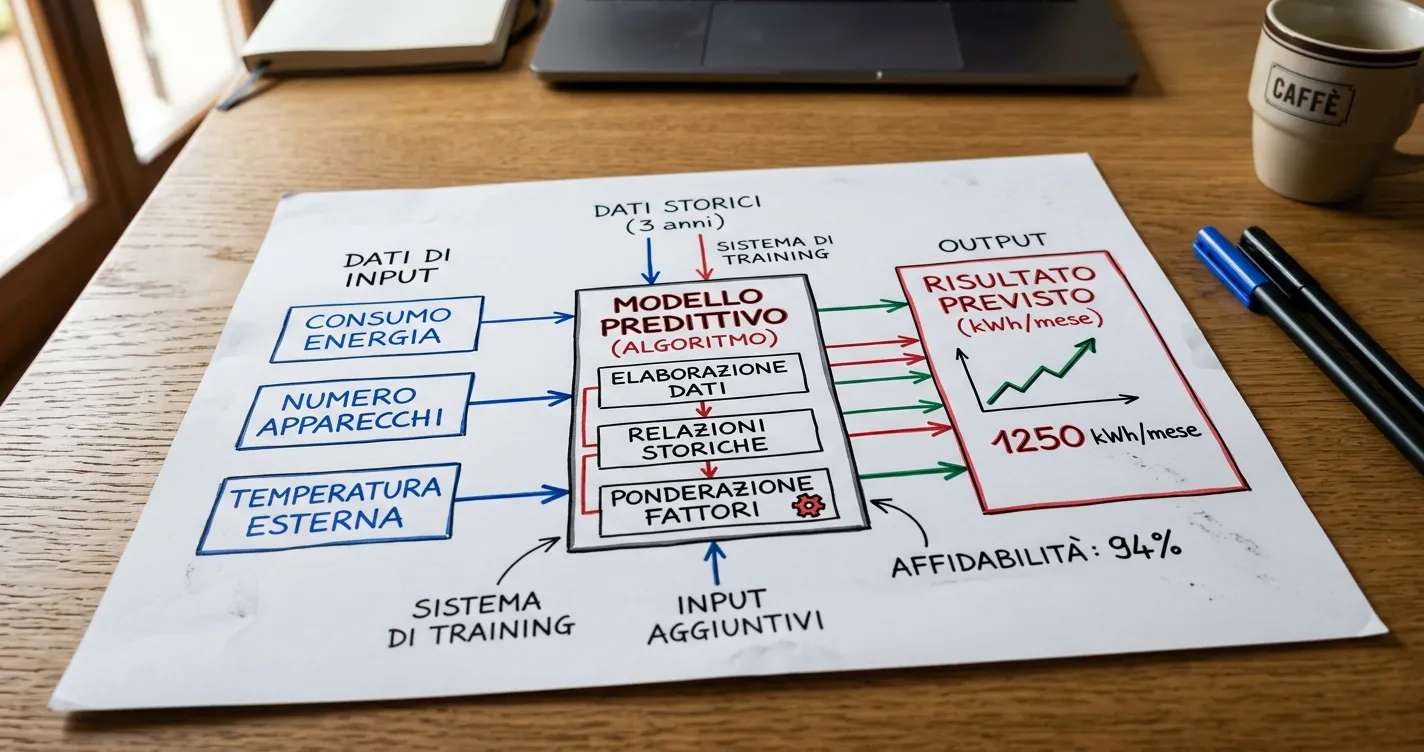
Le variabili che pesano di più nei miei modelli attuali variano per formato. Nel T20, il rendimento recente dei primi tre battitori e i numeri del miglior lanciatore nella death overs spiegano oltre il 40% della varianza nel risultato. Nel Test cricket, la sede della partita e le condizioni del pitch nei primi due giorni sono i predittori più forti. La sfida è combinare queste variabili senza overfitting, un errore che ho commesso troppo spesso nei primi mesi.
Errori comuni nell’uso dei dati
Il cherry-picking è il nemico numero uno dell’analisi statistica nel cricket. Ho visto scommettitori costruire tesi convincenti selezionando solo i dati che confermano la loro opinione. Un battitore che “gioca benissimo in trasferta” può sembrare tale se guardi solo le cinque migliori prestazioni, ignorando le quindici in cui ha fallito. L’unica difesa contro questo bias è lavorare con dataset completi e formule che non ammettono eccezioni.
Un altro errore frequente è ignorare il contesto. I numeri di un battitore contro un attacco specifico in una serie del 2022 sono utili, ma perdono rilevanza se quel battitore ha cambiato tecnica o se l’attacco ha sostituito il suo lanciatore migliore. I dati storici sono una guida, non una profezia. Ogni partita porta variabili nuove che i numeri passati non possono catturare completamente.
L’overcomplication è il terzo errore classico. Ho attraversato una fase in cui il mio modello aveva settantadue variabili, e i risultati erano peggiori del modello semplice con ventisei. Più variabili significano più rumore, più possibilità di overfitting e più difficoltà nel capire cosa funziona e cosa no. La regola che seguo ora è semplice: ogni nuova variabile deve migliorare la capacità predittiva di almeno il 2% su un campione fuori-campione, altrimenti viene eliminata.
L’evoluzione continua del vantaggio analitico
Il vantaggio che i dati offrono oggi non sarà lo stesso tra due anni. L’ICC ha investito massicciamente nella raccolta e distribuzione dei dati, con accordi di sponsorizzazione che superano i 110 milioni di dollari e che includono componenti tecnologiche significative. Più dati diventano pubblici, più il mercato diventa efficiente, e più bisogna affinare i propri strumenti per restare un passo avanti.
La direzione in cui mi sto muovendo è l’analisi in tempo reale durante le partite live. I dati ball-by-ball aggiornati ogni pochi secondi permettono di identificare cambiamenti nel momentum prima che le quote si aggiustino. Non è facile, richiede infrastruttura tecnica e velocità di esecuzione, ma è il prossimo livello dell’approccio value betting nel cricket.
Chi inizia oggi ha un vantaggio paradossale: può imparare dagli errori che i pionieri hanno già commesso. I principi fondamentali restano semplici. Raccogli dati puliti, costruisci modelli parsimoniosi, testa su dati che il modello non ha mai visto, e non scommettere mai più di quanto il tuo vantaggio statistico giustifichi. Tutto il resto è dettaglio.
Quali statistiche sono più importanti per le scommesse sul cricket?
Le metriche contestualizzate sono più utili delle medie generali. Per i battitori, lo strike rate nelle diverse fasi dell’innings. Per i lanciatori, il dot ball percentage e l’economy rate negli over finali. Per le partite, le condizioni del pitch e i dati meteorologici locali.
Serve saper programmare per usare i dati nelle scommesse cricket?
No, un foglio di calcolo è sufficiente per iniziare. Google Sheets permette di importare dati da fonti online e costruire modelli semplici con formule base. La programmazione diventa utile quando si vuole automatizzare la raccolta dati o lavorare con volumi molto grandi.
Scritto dal team di «Scommesse Cricket».